

AI 그림은 왜 엔비디아 그래픽카드일까요? CPU와 GPU 차이, CUDA 이야기로 풀어 봤어요. 등대지기 라보입니다.
손님이 어젯밤에 드디어 코야를 돌려 봤대요.
그런데 검은 창에 자꾸 "CUDA"라고 뜨더래요.
"쿠다가 뭐예요? 쓰고 싶으면 쓰는 거예요? 보통 로컬로 계산하잖아요."
오늘은 그 얘기예요. 왜 AI 그림은 엔비디아에서 잘 돌아가는지.
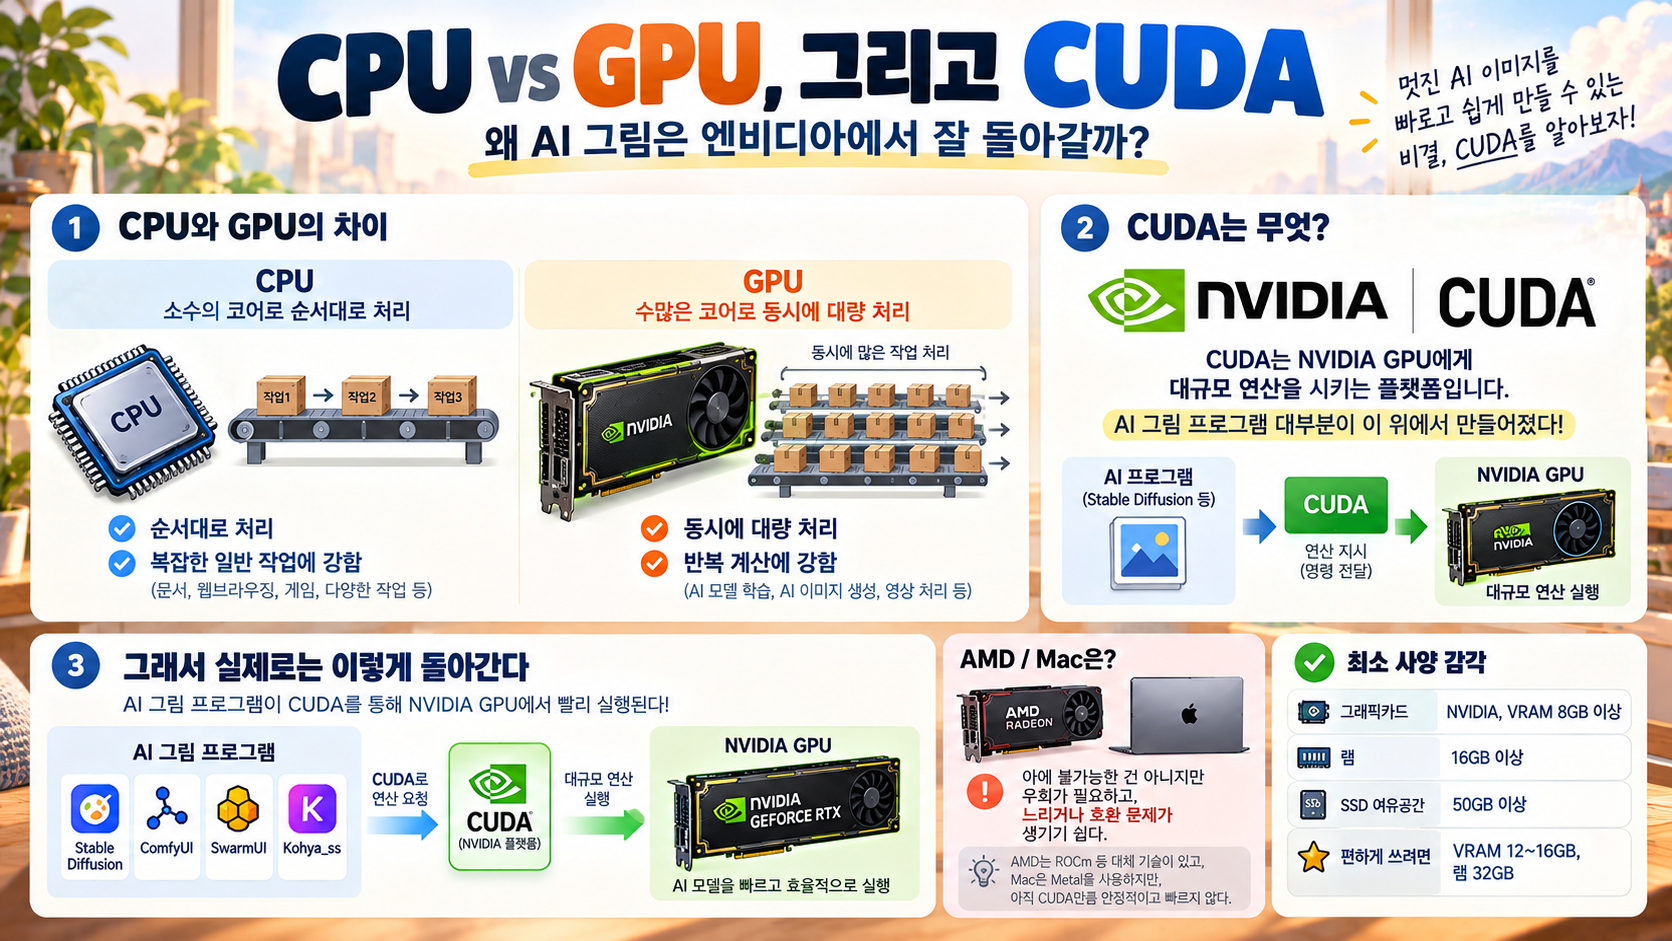
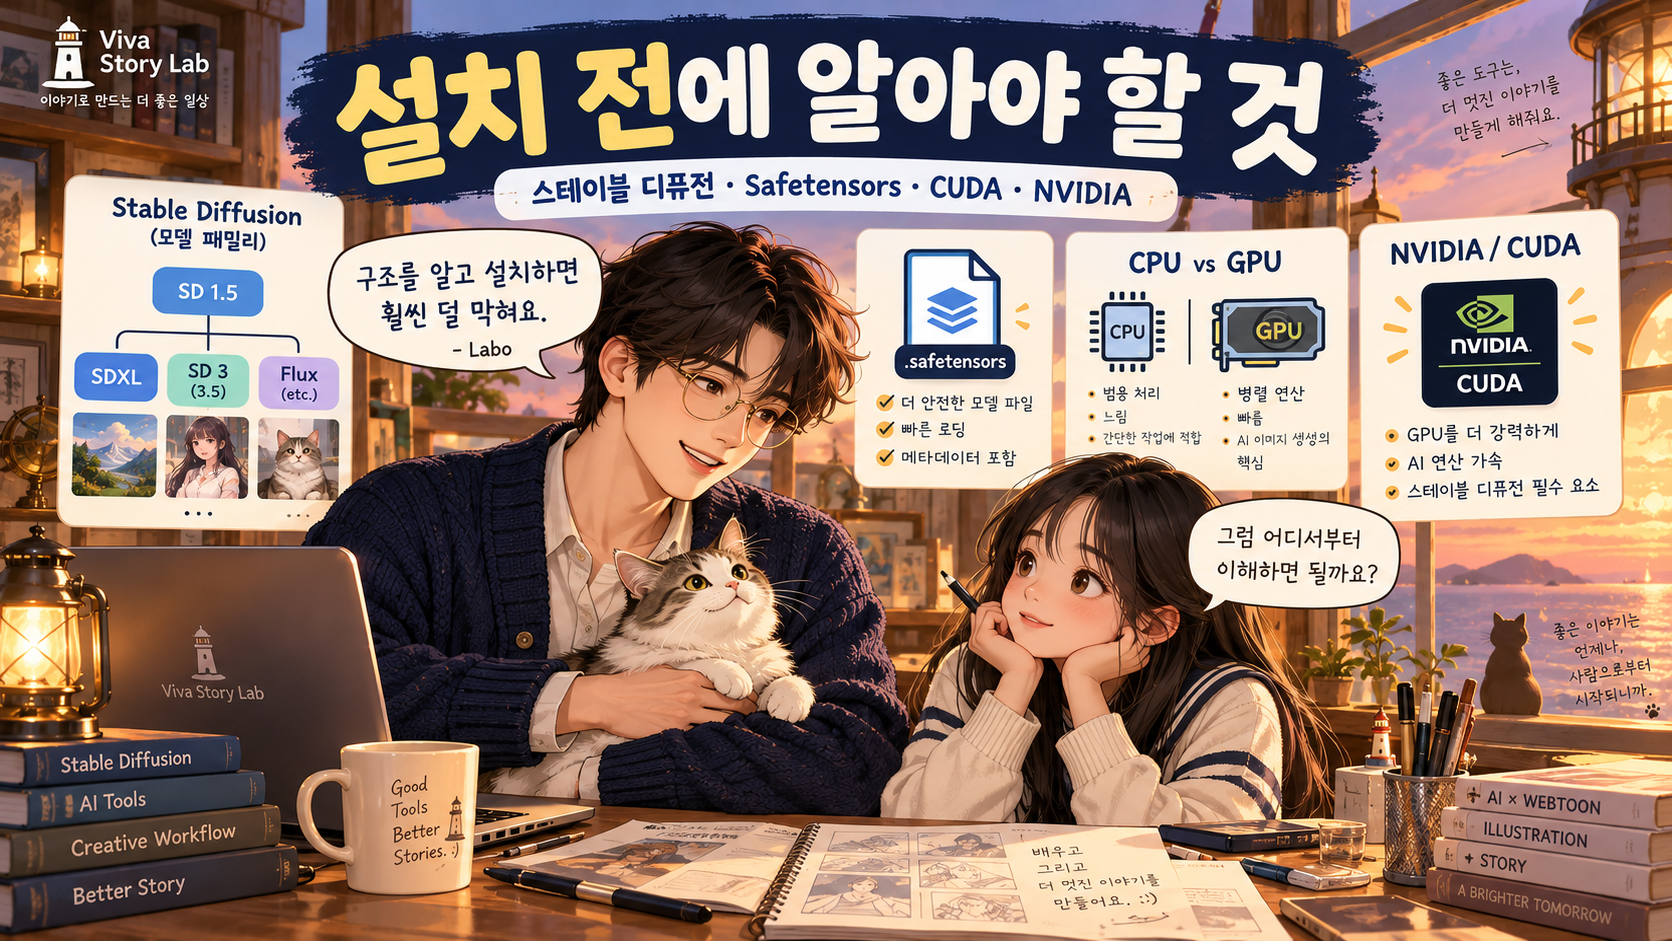
CPU vs GPU 그리고 CUDA, 왜 AI 그림은 엔비디아에서 잘 돌아갈까, CPU 순서대로 처리 GPU 동시에 대량 처리, AMD 맥은 우회 필요, 최소 사양 VRAM 8GB RAM 16GB
"쿠다를 쓰고 싶으면 쓰는 거예요?"
손님: 어제 검은 창에 쿠다라고 뜨던데. 쿠다는 옵션이에요?
라보: 옵션이 아니에요. 먼저 왜 그래픽카드가 필요한지부터. 그림 AI는 계산을 한 번에 수천 개씩 해야 해요. 컴퓨터의 머리인 CPU는 똑똑한데, 일을 줄 세워서 해요. 하나 끝내고 다음. 그래픽카드 GPU는 덜 똑똑한 일꾼이 수천 명 있어서 동시에 해요. 같은 계산을 수천 번 반복하는 AI엔 GPU가 맞아요.
손님: 그럼 쿠다는요?
라보: GPU한테 "이 계산 해라" 하고 말을 거는 통로예요. 엔비디아가 2007년부터 만든 거고요. 코야도, 스웜도, 콤피도 이 통로로 그래픽카드에 일을 시켜요. 쓰고 싶으면 쓰는 게 아니라, 엔비디아 카드가 있으면 자동으로 그 통로로 돌아요. 검은 창에 쿠다가 뜬 건 "지금 그래픽카드 쓰고 있다"는 뜻이에요. 잘 되고 있는 거예요.
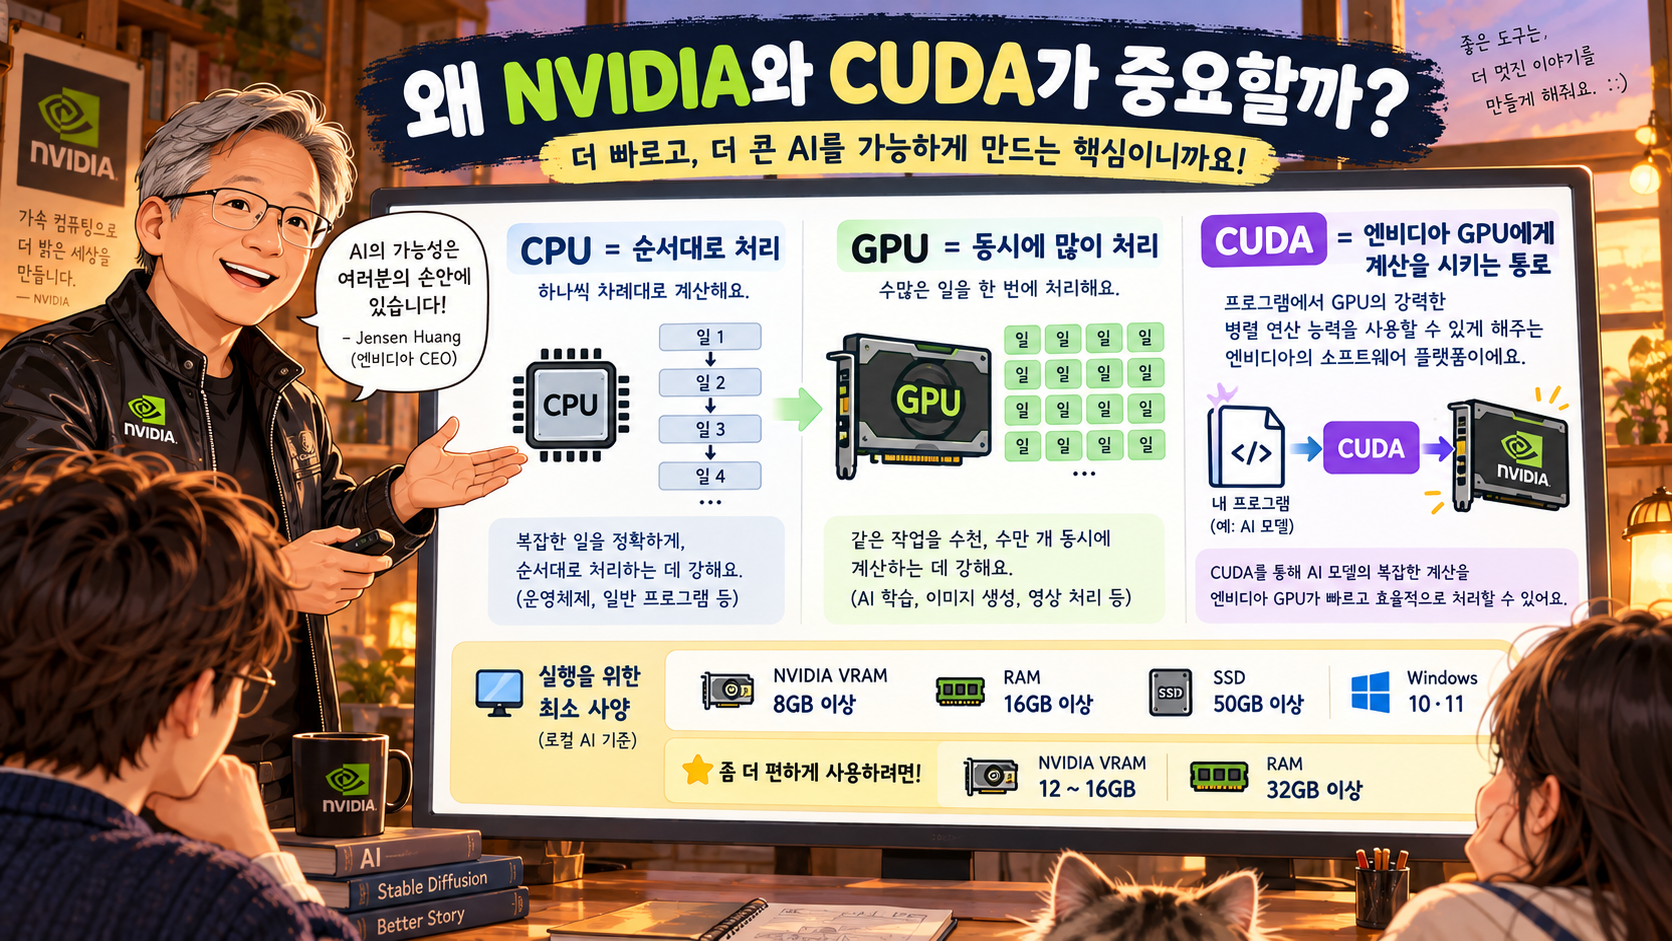
왜 NVIDIA와 CUDA가 중요할까, CPU 순서대로 처리 GPU 동시에 많이 처리 CUDA 엔비디아 GPU에게 계산을 시키는 통로, 실행을 위한 최소 사양
CPU는 한 줄, GPU는 수천 줄. 쿠다는 그 수천 줄에 일을 나눠 주는 통로.
"그럼 꼭 엔비디아여야 해요?"
손님: AMD 카드는요? 맥북은요?
라보: 이게 중요해요. AI 연구자들이 지난 15년 동안 전부 쿠다 위에서 코드를 짰어요. 코야, 스웜, 콤피 전부요. AMD나 맥에서도 돌리는 방법은 있어요. 그런데 우회해야 하고, 느리고, 업데이트 때마다 깨져요. 되긴 되는데 고생이에요. 처음 시작하는 사람한테는 권하지 않아요.
손님: 제 컴퓨터는 엔비디아예요. RTX 3050.
라보: 그럼 됐어요. 메모리가 몇이에요?
손님: 8GB요. 램은 16GB.
"그걸로 돼요?"
라보: 됩니다. 딱 최소예요.
| 최소 | 편하게 | |
|---|---|---|
| 그래픽카드 | 엔비디아, 메모리(VRAM) 8GB | 12~16GB |
| 램 | 16GB | 32GB |
| 디스크 | SSD, 50GB 비움 | 200GB |
| 운영체제 | Windows 10/11 | 같음 |
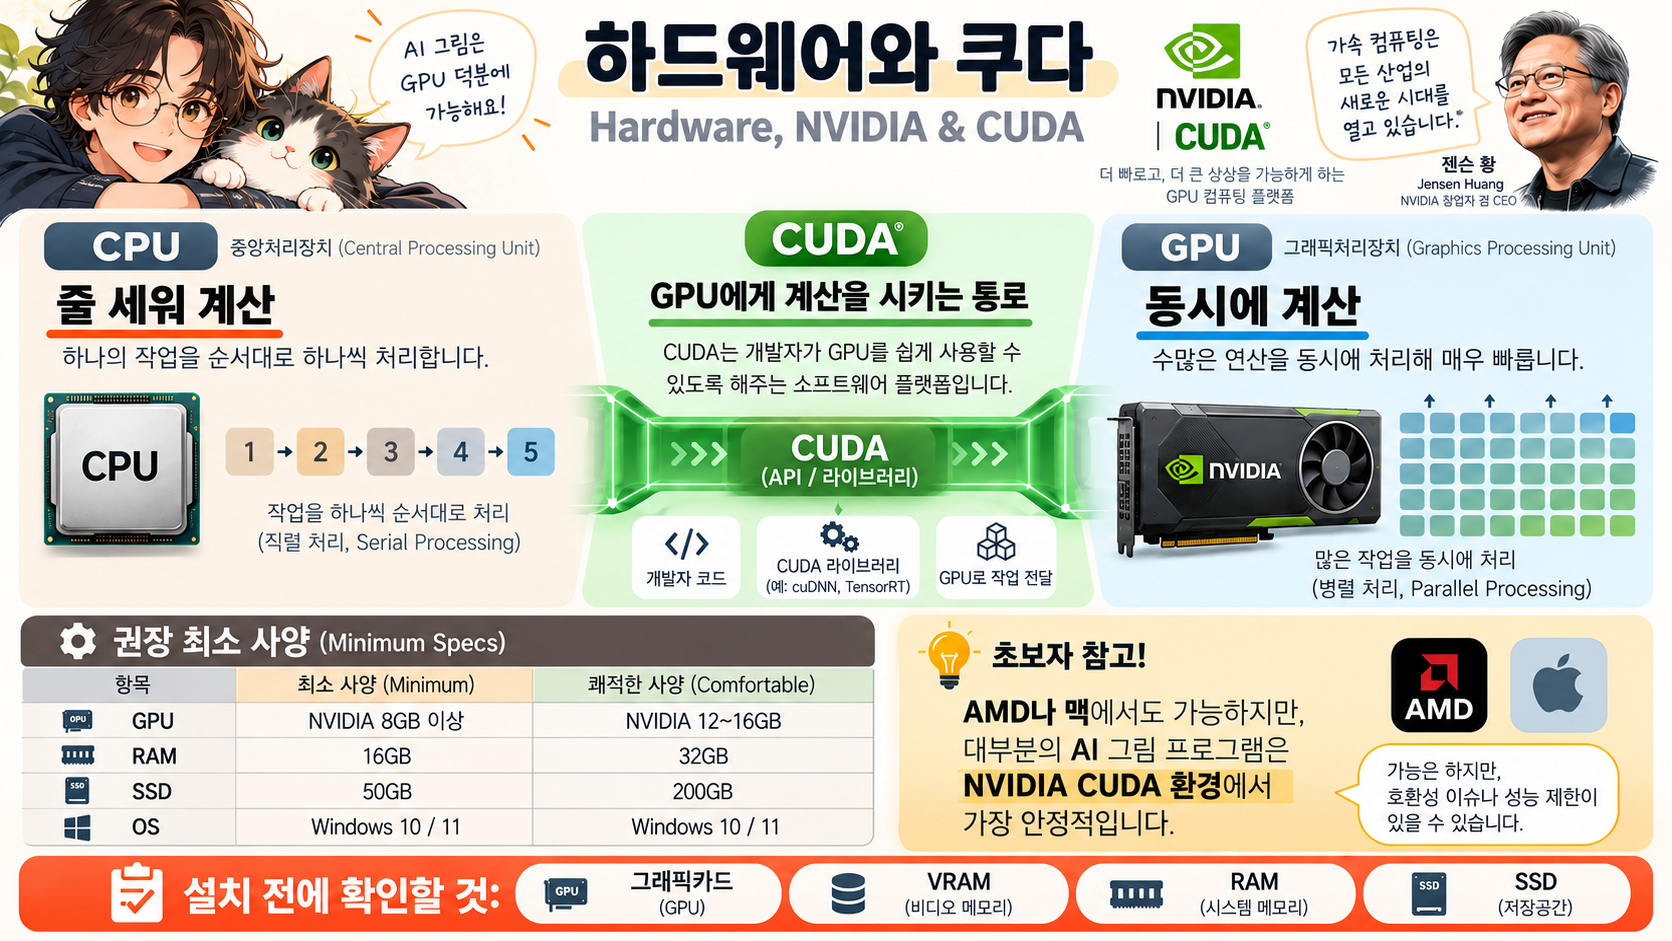
하드웨어와 쿠다, CPU 줄 세워 계산 GPU 동시에 계산 CUDA 통로, 권장 최소 사양 NVIDIA 8GB RAM 16GB SSD 50GB, 설치 전에 확인할 것 그래픽카드 VRAM RAM SSD
설치 전에 확인할 것 넷. 그래픽카드, VRAM, RAM, SSD.
라보: 8GB면 SDXL 그림을 뽑는 건 돼요. 느리게. 아버지 그림체를 가르치는 건 8GB와 램 16GB에서 아슬아슬해요. 거기서 막히면 그래픽카드를 빌리는 길이 있고요. 지도의 런팟. 그건 막혀 봐야 알아요.
손님: VRAM이랑 RAM이 다른 거예요?
라보: 달라요. VRAM은 그래픽카드 안의 메모리, RAM은 컴퓨터 본체의 메모리. 모델 파일은 VRAM에 올라가고, 나머지 일은 RAM이 해요. 둘 다 봐야 해요. 손님처럼 VRAM 8GB에 RAM 16GB면, 뜻밖에 RAM이 먼저 막힐 수 있어요. 그 얘기는 실제로 막혔을 때.
복습 한 장
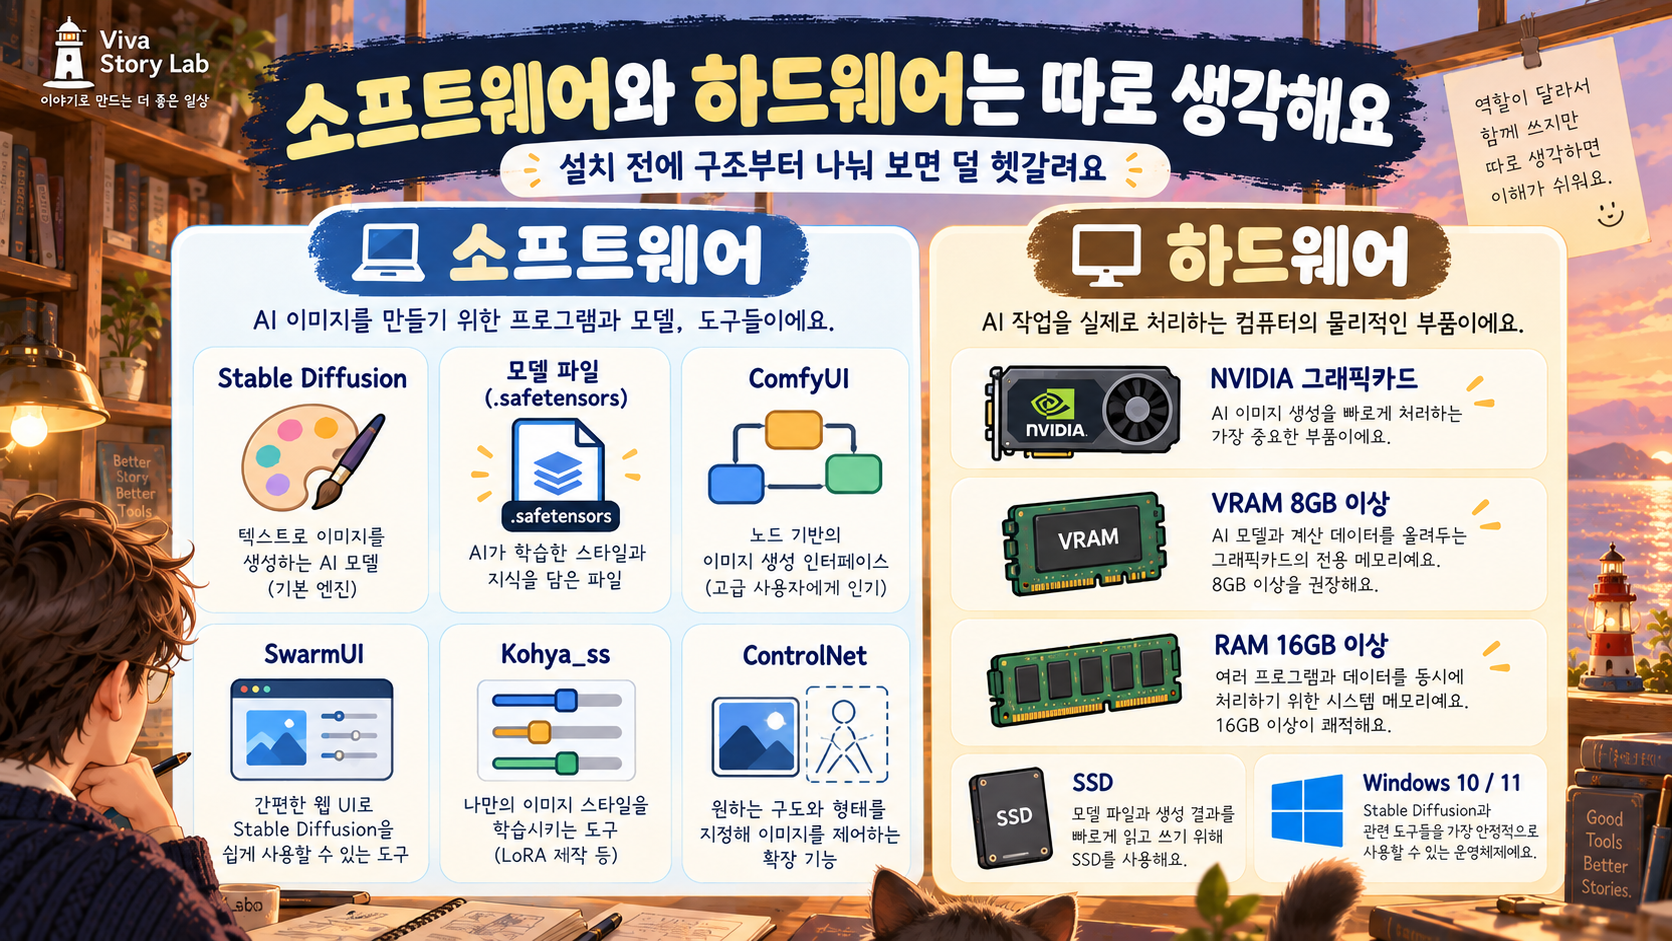
소프트웨어와 하드웨어는 따로 생각해요, 왼쪽 깔 것 오른쪽 있어야 할 것
지난 편 그림. 오늘은 오른쪽 전부를 했어요. 이제 왼쪽을 설치할 차례.
손님: 그럼 이제 진짜 설치해요?
라보: 네. 그런데 세 군데서 막힐 거예요. 미리 말해 드릴게요!
자주 묻는 질문
Q. CUDA가 뭐예요?
프로그램이 엔비디아 그래픽카드에 계산을 시키는 통로예요. 엔비디아 카드가 있으면 자동으로 써요. 따로 켜고 끄는 게 아니에요.
Q. AI 그림은 꼭 엔비디아여야 하나요?
필수는 아니지만 사실상 그래요. 프로그램들이 전부 쿠다 위에서 만들어져서, AMD나 맥은 우회해야 하고 느리고 자주 깨져요.
Q. VRAM 8GB로 AI 그림 돼요?
생성은 돼요. 느려요. 그림체 학습은 램까지 봐야 하고, 막히면 클라우드(런팟)로 빌려요.
Q. VRAM과 RAM 차이는?
VRAM은 그래픽카드 메모리, RAM은 본체 메모리. 둘 다 최소 기준이 있어요. 8GB / 16GB.
공식 주소
NVIDIA CUDA 공식 페이지 (보통 따로 깔 필요 없어요. 드라이버에 들어 있어요)
NVIDIA 드라이버 다운로드 (이건 최신으로 유지하세요)
RunPod (집 컴퓨터가 막힐 때 그래픽카드 빌리는 곳, 유료)
시리즈 · AI 웹툰 그리려면
1편 AI 웹툰 그리려면 어떻게 해야할까
2편 스테이블 디퓨전이 뭐예요?
3편 SD1.5, SDXL, FLUX, 조상 하나에 자식 수천
4편 세이프텐서는 왜 이름이 그래요?
5편 (이 글) 왜 엔비디아예요? CPU와 GPU와 쿠다, 그리고 최소 사양
6편 (다음) 코야 설치에서 막히는 곳 셋
작성 기준: 2026년 10월. 사양표는 SDXL 기준이에요.
등대 일지. 되나 안 되나는 광고 문구가 아니라 숫자 넷이 말해 준다. 그래픽카드, VRAM, RAM, SSD.
'AI 스튜디오' 카테고리의 다른 글
| 로라 학습 그림 몇 장이 좋아요? 캡션·트리거 워드는요? (0) | 2026.10.24 |
|---|---|
| Kohya_ss 윈도우 설치가 계속 막혀요, 어디서 오류 나요? (0) | 2026.10.23 |
| safetensors와 ckpt 파일은 뭐가 달라요? 왜 위험하대요? (0) | 2026.10.21 |
| SD1.5, SDXL, FLUX는 뭐가 달라요? (0) | 2026.10.20 |
| 스테이블 디퓨전이 뭐예요? 내 컴퓨터에 설치해도 되나요? (0) | 2026.10.19 |


