

로라 학습한 같은 캐릭터가 옷만 바뀌면 다른 사람처럼 나오는 건, AI가 옷으로 사람을 알아보기 때문이에요. 등대지기 라보입니다. 오늘은 로라 학습을 마친 같은 캐릭터가 왜 다른 사람처럼 나오는지, 옷만 바뀌면 낯선 사람이 되고 전신 컷에서는 인체가 무너진 제 기록을 이야기할게요. 해 보고 남은 생각은 하나예요. 제 생각엔 옷이 바뀌면 AI는 같은 사람으로 못 알아봐요. 그림 크기를 자동으로 맞추는 법을 배운 손님이 "이제 진짜로 뽑아 봐도 돼요?" 하고 들어왔거든요.
옷만 갈아입었을 뿐인데, 그림 속 그 사람이 낯설어지는 날이에요.
"로라 학습 끝났으니 같은 캐릭터로 뽑아 봐도 돼요?"
손님: 라보 씨, 지난번에 크기는 노드가 알아서 맞추게 해 놨잖아요. 그럼 이제 로라 걸고 뽑기만 하면 되는 거죠?
라보: 저도 딱 그 기분이었어요. 크기 자동화까지 끝내고 나니까, 이제 남은 건 제대로 뽑아 보는 것뿐이라고 생각했죠.
손님: 어떤 로라로요?
라보: 에폭 4랑 6 얘기 할 때 나온 그 두 번째 그림체 로라예요. 다시 정리하면 이래요.
- 런팟(RunPod) RTX 4090에서 학습
- 그림 55장 × 반복 5 × 10에폭 = 2,750스텝
- 캡션은 Claude와 GPT가 서로 교차로 검토해서 정확도 약 95%
- 에폭 파일 1번부터 9번까지 + 최종 파일. 그중 에폭 5가 제일 좋았고, 6도 같이 썼어요
손님: 첫 번째 로라 때보다 훨씬 준비를 많이 하셨네요.
라보: 네. 첫 로라는 36장이었는데 이번엔 55장이었고, 캡션도 Claude와 GPT 둘이 봤어요. 그리고 6월 7일, 이 로라로 본격적으로 뽑아 봤어요.
"클로즈업은 됐는데 전신은요?"
손님: 결과는요? 이번엔 됐어요?
라보: 반은 됐어요. 클로즈업 컷은 그림체가 살았어요. 얼굴이 화면을 꽉 채우는 컷에서는 제가 가르친 그 그림체가 나왔어요.
손님: 와, 드디어요! 그럼 나머지 반은요?
라보: 전신 컷은 두 번 다 실패했어요. 머리부터 발끝까지 다 들어가는 컷이요.
손님: 클로즈업이랑 전신이 그렇게 달라요? 같은 사람 그리는 건데요.
라보: 컷 크기에 따라 AI가 그려야 하는 게 달라져요. 클로즈업은 얼굴, 머리카락, 눈 정도가 화면 대부분이에요. 전신은 거기에 어깨, 팔, 손, 허리, 다리, 발, 옷 주름까지 다 들어가요. 그릴 게 많아지는 만큼, 학습 그림에서 그걸 제대로 배웠는지가 그대로 드러나요.
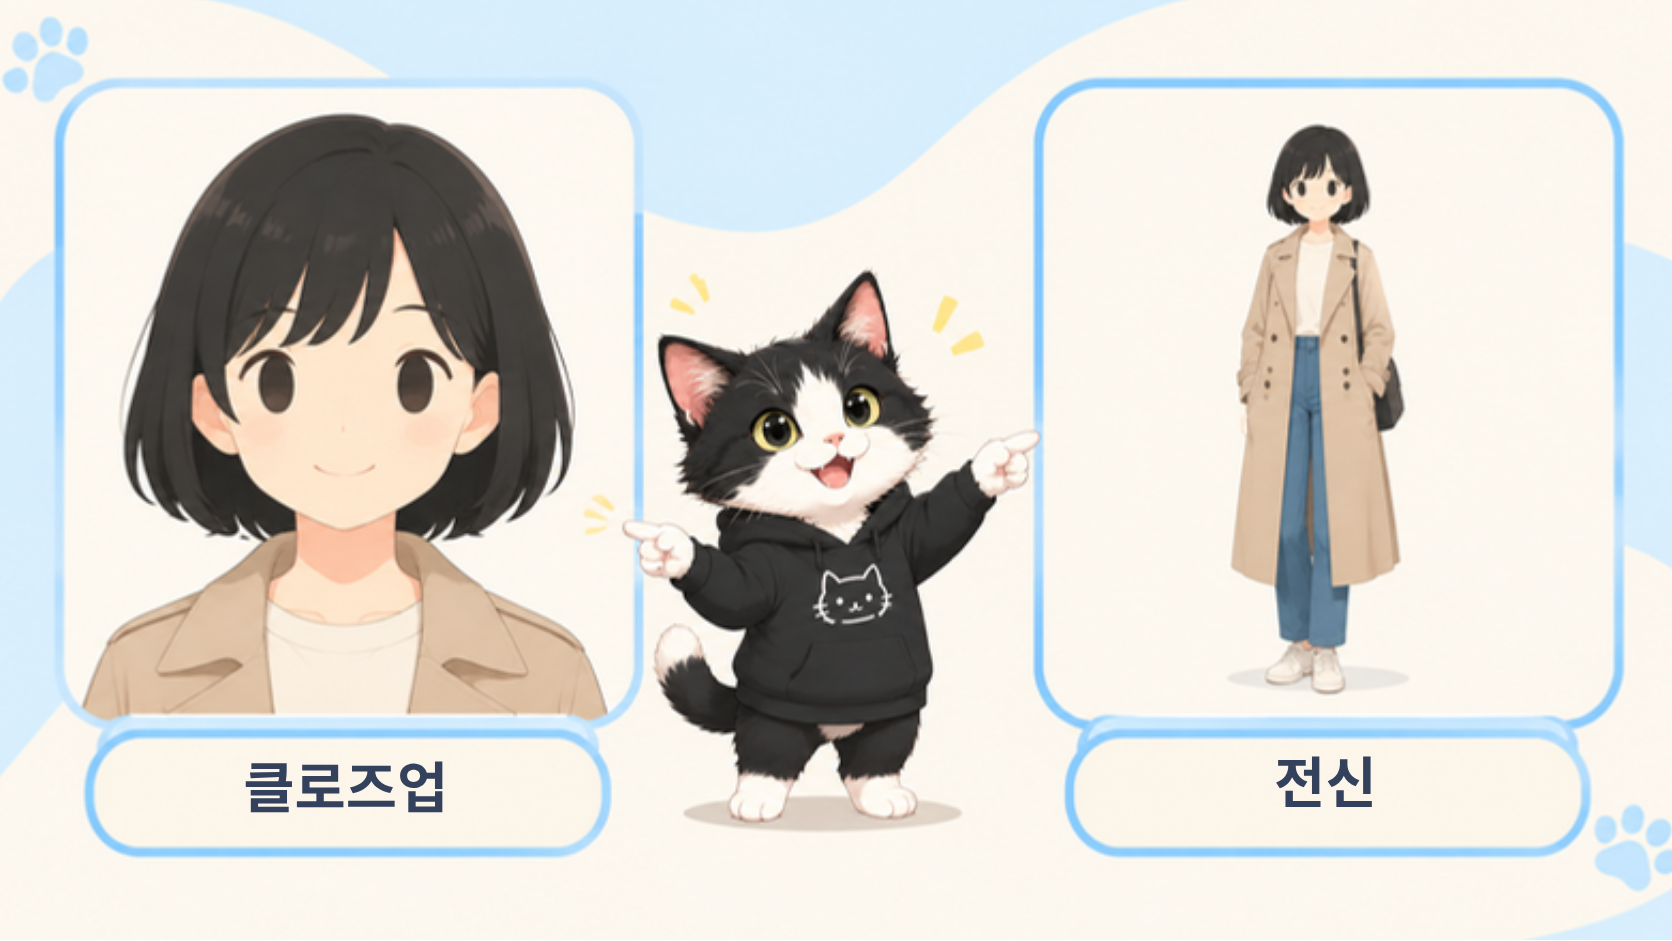
같은 여자를 클로즈업과 전신으로 나란히 둔 예시예요. 전신은 그려야 할 것이 훨씬 많아요.
손님: 그럼 전신은 어떻게 실패했어요? 생각과 전혀 다른 그림이요?
라보: 이번엔 실패가 두 가지였어요.
- 여러 옷을 입은 같은 여자가 한 사람으로 인식되지 않았어요. 옷이 바뀐 컷마다 다른 사람처럼 나왔어요.
- 인체도 잘 안 나왔어요. 전신 컷에서 몸이 제 모양으로 그려지지 않았어요.
"사람한텐 당연한 같은 사람이, AI한텐 왜 어려워요?"
손님: 이상하다. 웹툰 주인공은 화마다 옷을 갈아입잖아요. 그래도 독자는 다 같은 사람인 줄 알고요.
라보: 사람은 그래요. 얼굴, 머리 모양, 몸매, 서 있는 버릇 같은 걸 보고 "아, 그 사람이네" 하죠. 옷은 그냥 갈아입은 거고요. 그런데 AI는 우리처럼 "이건 같은 사람이고 옷만 다르다"를 처음부터 알고 배우는 게 아니에요. 그림 55장을 보면서 자주 같이 나오는 것들을 묶어서 배울 뿐이에요.
손님: 그럼 옷이 다 다르면요?
라보: 여기서부터는 제 짐작이에요. 확인한 건 아니에요. 제 생각엔 옷이 너무 다양해서 몸을 못 배운 것 같아요. 그림마다 옷이 다르면, 옷 밑에 있는 몸의 모양은 매번 다른 천에 가려져 있잖아요. 어떤 그림은 긴 코트, 어떤 그림은 짧은 옷이고요. AI 입장에선 "이 사람 몸은 원래 이렇게 생겼다"를 볼 기회가 별로 없었던 것 같아요.
손님: 아, 그래서 인체도 안 나오고, 한 사람으로도 안 보였던 거예요?
라보: 둘이 같은 뿌리였던 것 같아요. 몸을 못 배웠으니 전신에서 몸이 무너지고, 몸이라는 공통점이 없으니 옷이 바뀔 때마다 다른 사람이 된 거죠. 다시 말하지만, 이건 제가 결과를 보고 한 짐작이에요. 그래도 이 일로 하나는 알았어요. 제 생각엔 사람에겐 당연한 "같은 사람"이 AI에겐 가장 어려운 일이에요.
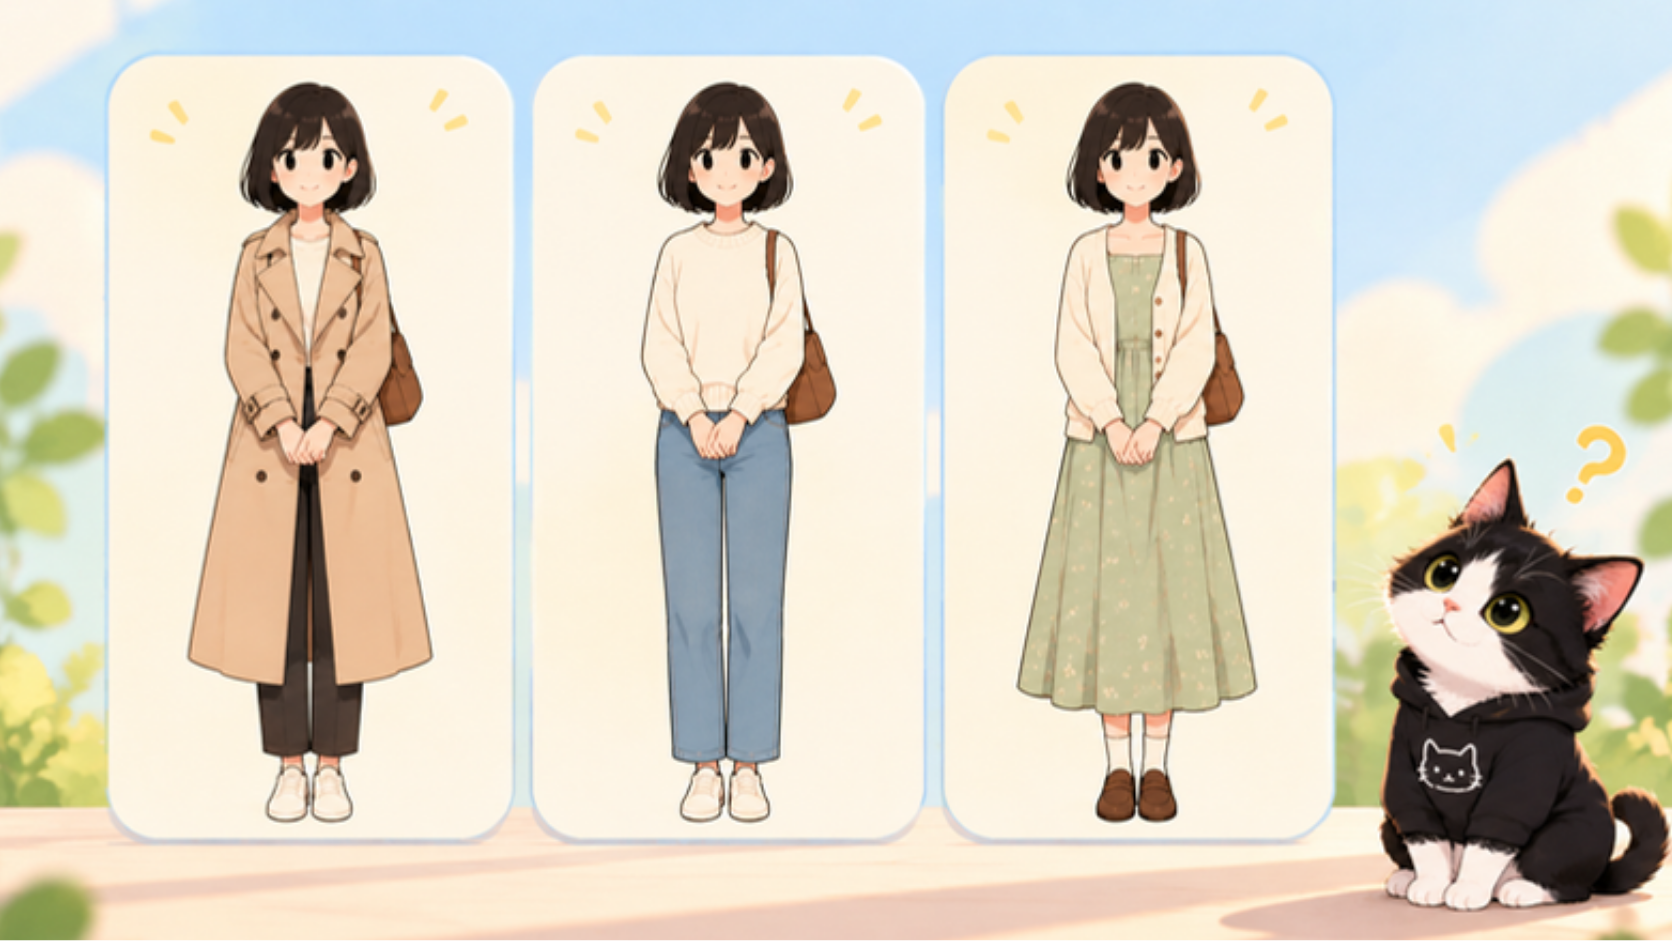
같은 여자가 옷만 바꿔 입은 예시예요. 사람 눈엔 한 사람인데, 옷이 몸을 가리는 모양은 그림마다 달라요.
"55장 안에는 뭐가 들어 있었어요?"
손님: 그 55장은 어떤 그림이었어요? 다 그 여자 그림이에요?
라보: 아니요. 55장을 파일 이름으로 훑어보면 두세 명이 같이 나오는 장면과 배경 그림이 많이 섞여 있었어요.
손님: 어, 그거 첫 로라 때 얘기랑 비슷하지 않아요? 작품을 통째로 넣었다가 AI가 뭘 배울지 몰랐다던.
라보: 손님도 그걸 떠올렸네요. 첫 로라 때 남긴 말이 "좋은 그림이 아니라 가르칠 것 하나만 보이는 그림을 넣는다"였어요. 55장은 그때보다 훨씬 잘 고른 묶음이었지만, 여러 명이 나오는 컷과 배경 컷은 여전히 많았어요. 그게 이번 실패에 얼마나 섞여 있었는지는 저도 몰라요. 제가 제일 크게 본 건 옷이었어요.
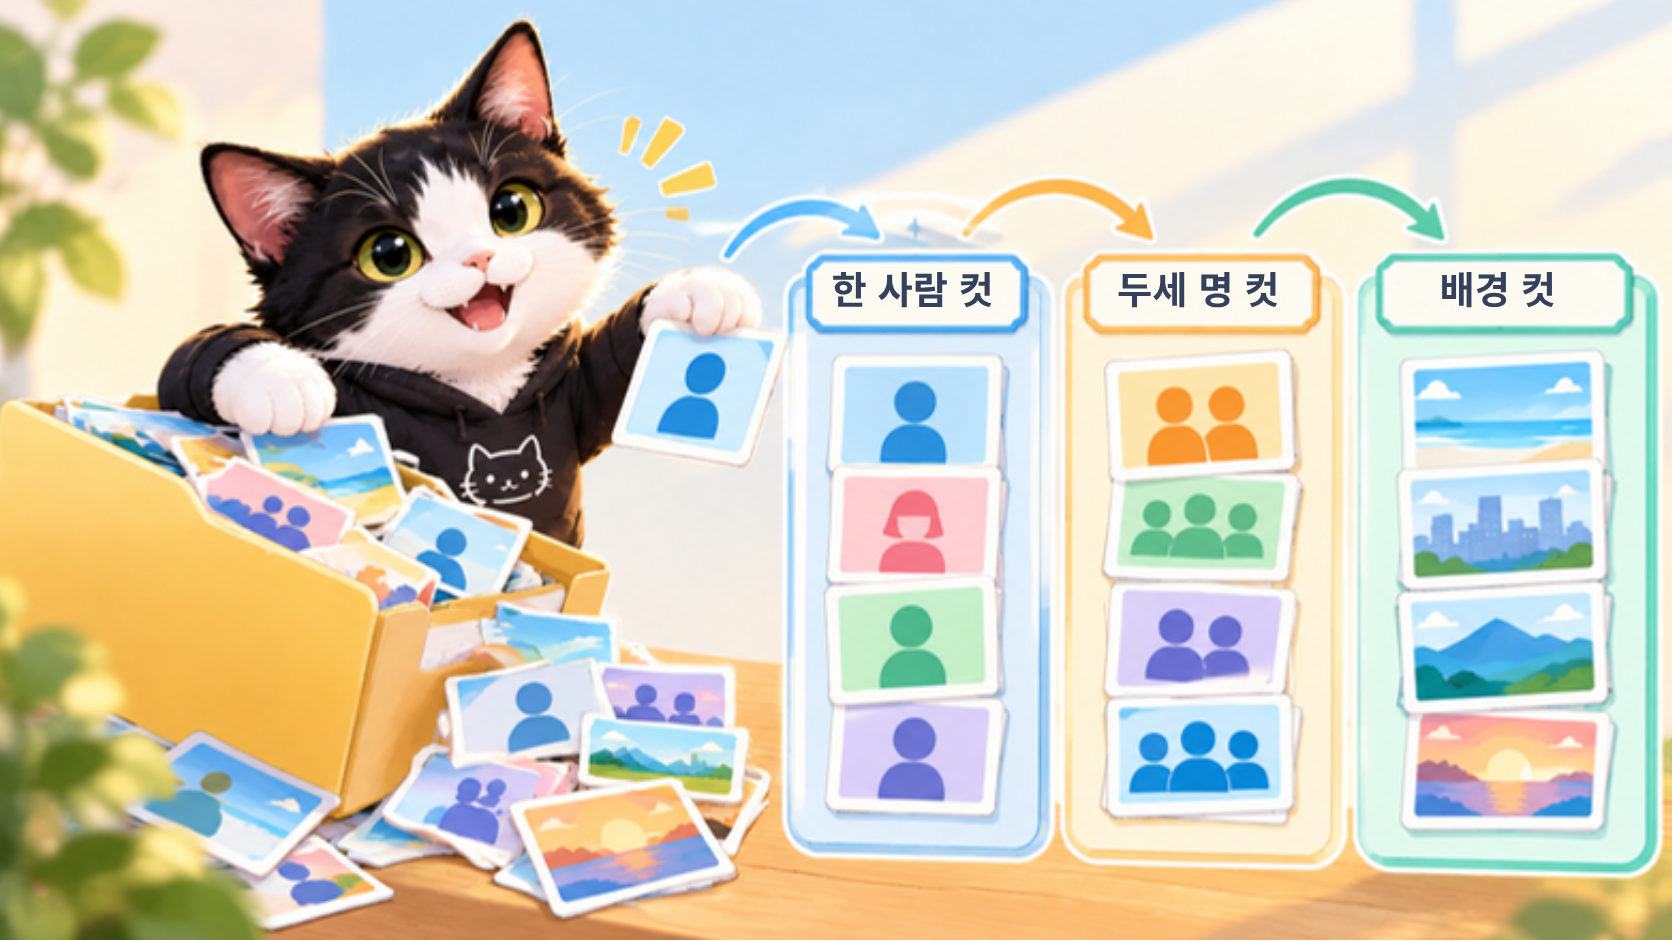
한 사람 컷, 두세 명 컷, 배경 컷이 한 폴더에 섞여 있는 모습을 나눠 본 그림이에요.
손님: 그럼 저는 아빠 그림 고를 때 뭘 보면 돼요?
라보: 제 경험으로 말하면, 고를 때 이 셋은 한 번 세어 보세요.
- 이 그림에 사람이 몇 명 나오는지
- 사람 없이 배경만 있는 그림인지
- 같은 사람이 나오는 그림들끼리 옷이 얼마나 다른지
그림 고르는 기준 자체는 그림 몇 장 준비하는 편에서 한 그대로예요. 오늘은 거기에 "옷"이라는 줄이 하나 더 생긴 거예요.
"그럼 몸은 어떻게 가르쳐요?"
손님: 옷 때문에 몸을 못 배운 거라면요, 옷을 빼면 되잖아요?
라보: 그쵸. 저도 거기까지 생각이 갔어요. 옷 입은 그림으로 그림체를 가르치는 것과, 몸의 생김새를 가르치는 걸 한 묶음에 같이 하지 말고 나눠 보자고요.
손님: 나눈다고요? 몸만 따로요?
라보: 네, 몸만 따로요. 그게 다음 편 얘기예요. 그리고 그건 지금 잘 나오고 있어요.
자주 묻는 질문
Q. 로라로 뽑으면 같은 캐릭터가 옷마다 다른 사람처럼 나와요.
제 경우엔 학습 그림 속 옷이 너무 다양했어요. 제 생각엔 옷에 가려 몸을 못 배운 것 같아요. 저는 그 뒤 몸의 구조만 보이는 그림을 따로 가르쳤어요.
Q. 클로즈업은 잘 나오는데 전신만 무너져요.
저도 그랬어요. 클로즈업은 그림체가 살았는데 전신은 두 번 다 실패했어요. 전신은 몸 전체를 그려야 해서 학습 그림에서 몸을 제대로 배웠는지가 드러나요.
Q. 학습 그림에 여러 명이 나오는 장면이나 배경을 넣어도 돼요?
제 55장에는 두세 명 장면과 배경 그림이 많이 섞여 있었어요. 고를 때 그림마다 사람이 몇 명인지, 배경만 있는 그림인지 한 번 세어 보세요.
공식 주소
ComfyUI 공식 깃허브 (오픈소스, 무료)
Kohya_ss 공식 깃허브 (오픈소스, 무료)
RunPod (유료, 시간당 요금은 사이트에서 확인)
Claude (Anthropic)
ChatGPT (OpenAI)
※ 깃허브는 코드를 공개해 두는 사이트라 실행 전에 안에 뭐가 들었는지 누구나 볼 수 있어요.
이 편에서 작가가 한 일
그림 55장을 골라 런팟에서 학습시키고, 에폭 파일 중 5와 6을 골라 썼어요.
뽑은 그림을 보고 클로즈업은 되고 전신은 두 번 다 실패한 걸 가려냈어요. 옷이 너무 다양해서 몸을 못 배운 것 같다는 짐작도 작가 몫이었어요.
AI에게 맡긴 일
55장의 캡션을 Claude와 GPT가 서로 교차로 검토했어요(정확도 약 95%).
RTX 4090에서 2,750스텝 학습과, 그 로라로 그림 뽑기를 맡겼어요.
시리즈 · AI 웹툰 그리려면
1편 AI 웹툰 그리려면 어떻게 해야할까
2편 스테이블 디퓨전이 뭐예요?
3편 SD1.5, SDXL, FLUX는 뭐가 달라요?
4편 세이프텐서는 왜 이름이 그래요?
5편 AI 그림은 왜 엔비디아예요?
6편 kohya 코야
7편 그림은 몇 장 준비해야 할까?
8편 kohya 학습과 LoRA
9편 그림체 잘 나오나요?
10편 1스텝에 52초, 왜 이렇게 느린거지
11편 런팟은 어떻게 써요?
12편 로라 학습에 좋은 그림을 다 넣었는데 왜 엉뚱한 그림이 나와요?
13편 내 그림, AI 그림 사이트에 올려도 괜찮아요?
14편 스웜 대신 ComfyUI, 포터블로 어떻게 깔아요?
15편 ComfyUI 노드, 기본 워크플로는 어떻게 이어요?
16편 ComfyUI 워크플로 JSON 파일이 왜 안 열려요?
17편 로라 에폭 4랑 6 그림이 왜 똑같아요?
18편 ComfyUI 그림 크기, 매번 손으로 넣어요?
19편 (이 글) 로라 학습, 같은 캐릭터가 왜 다른 사람처럼 나와요?
20편 (다음) 로라로 인체가 자꾸 틀어질 때, 몸부터 가르치면 돼요?
21편 로라 캡션, AI한테 맡겨도 돼요?
22편 ControlNet 스케치를 넣으면 AI 그림체가 달라져요?
23편 AI 채색했더니 왜 그림이 납작해져요?
24편 AI 웹툰 얼굴, FaceDetailer로도 왜 아직 안 돼요?
작성 기준: 2026년 10월, 라보의 실제 기록. 원인은 제가 결과를 보고 한 짐작이고, 확인된 결론은 아니에요. 프로그램 화면과 버전은 바뀔 수 있어요.
등대 일지. 배는 돛을 바꿔 달아도 같은 배다. 사람 눈엔 당연한 그 사실이, 제 생각엔 AI에겐 가장 어려운 일이다.
'AI 스튜디오' 카테고리의 다른 글
| 로라 캡션, AI한테 맡겨도 돼요? (0) | 2026.11.08 |
|---|---|
| 로라로 인체가 자꾸 틀어질 때, 몸부터 가르치면 돼요? (1) | 2026.11.07 |
| ComfyUI 그림 크기, 매번 손으로 넣어요? (0) | 2026.11.05 |
| 로라 에폭 4랑 6 결과가 똑같이 나와요, img2img 때문일까요? (0) | 2026.11.04 |
| ComfyUI 워크플로 JSON 파일이 왜 안 열려요? (0) | 2026.11.03 |


